AI 크롤러 로그 분석 5단계: 세일 페이지 수집 주기 재는 법
AI 크롤러 로그 분석은 서버·CDN 접속 기록에서 AI 크롤러만 분리해 방문 빈도·수집 간격·응답 코드·재방문 지연 4개 값을 재는 작업입니다. 첫 집계 약 90분이면 가격 페이지를 며칠 전에 올려야 하는지 역산할 수 있습니다.
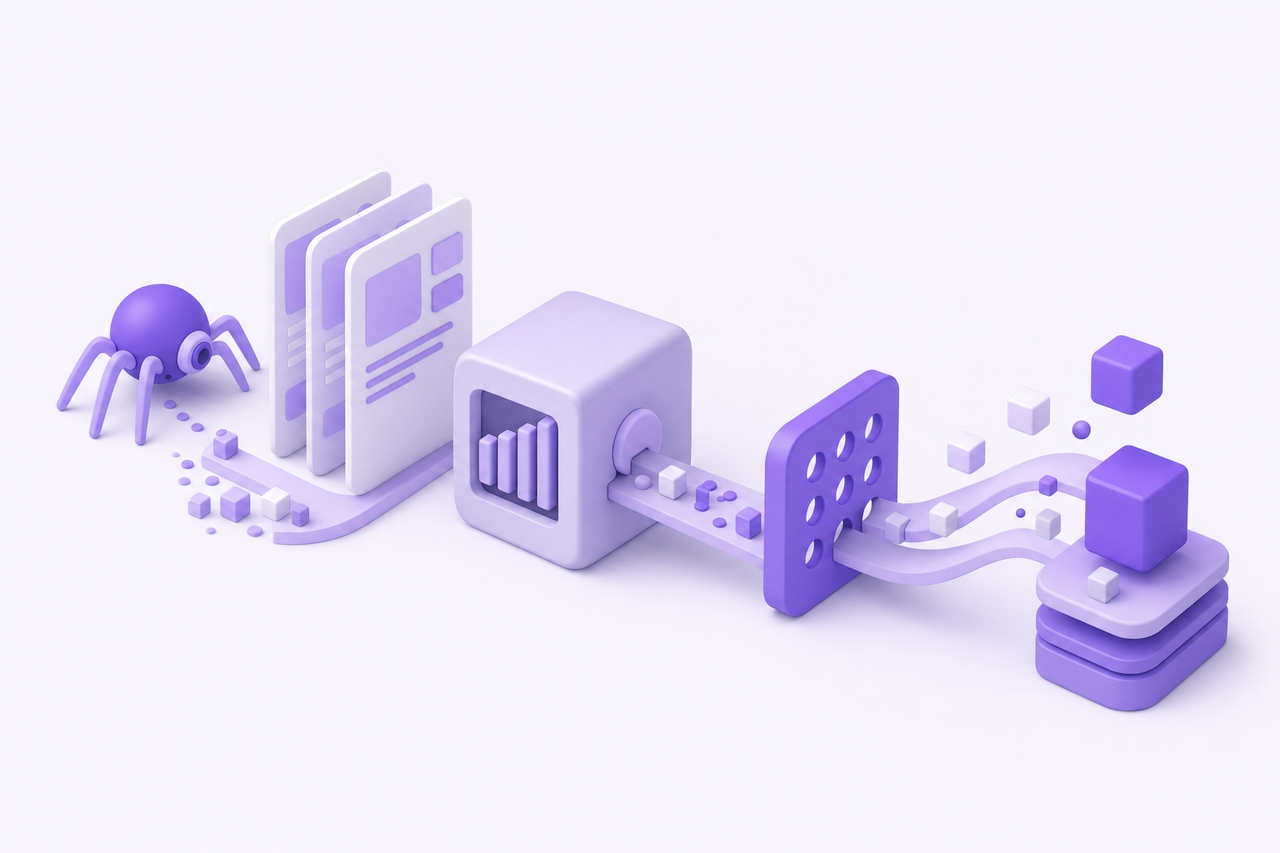
AI 크롤러 로그 분석은 서버 접속 기록에서 AI 크롤러만 분리해 수집 빈도와 간격을 숫자로 재는 작업입니다.
서버나 CDN(콘텐츠 전송망, 사이트 파일을 대신 전달해 주는 서비스) 로그를 14~30일치 내려받아 User-Agent(접속한 프로그램이 스스로 밝히는 이름표)로 걸러내면, 방문 빈도·수집 간격·응답 코드·재방문 지연 4개 값이 나옵니다. 이 4개만 있으면 가격이 바뀌는 페이지를 며칠 전에 올려야 하는지 역산할 수 있습니다. 첫 집계는 약 90분, 이후 갱신은 주 1회 20분이면 됩니다.
- 인용 순위보다 수집이 먼저입니다 — 한 번도 긁어가지 않은 주소는 어떤 AI 답변에도 등장할 수 없습니다. 수집 여부를 증명하는 기록은 서버 로그뿐입니다.
- 재방문 간격의 중앙값이 공개 시점을 정합니다 — 같은 주소 재방문 간격의 중앙값(값을 줄 세웠을 때 가운데 값)이 6일이면, 가격 변경은 최소 8일 전에 올립니다.
- 응답 코드 한 열로 수집 실패를 잡습니다 — 방문은 많은데 403·404·503이 섞여 있으면 빈도와 상관없이 새 내용이 반영되지 않습니다.
이미 AI 답변 속 브랜드 언급 횟수를 집계하고 있는 분보다, 새로 올린 가격·혜택 페이지가 수집이라도 됐는지 확인할 방법을 모르는 분에게 맞는 글입니다.
새로 올린 가격 페이지, AI가 왜 아직 모를까요?
AI 답변에 우리 가격이 안 나오는 이유는 크게 두 가지입니다. 하나는 수집 자체가 되지 않은 경우, 다른 하나는 수집은 됐지만 예전 버전이 남아 있는 경우입니다. 답변 화면만 봐서는 이 둘이 구분되지 않습니다.
구분하는 방법은 서버 로그를 여는 것뿐입니다. 로그에는 누가, 언제, 어떤 주소를, 어떤 결과 번호로 가져갔는지가 한 줄씩 남습니다. AI 크롤러(웹페이지를 자동으로 긁어가는 수집 프로그램)도 예외 없이 이 기록을 남깁니다.
홈웨어 셀러(온라인 판매자)는 할인 안내 페이지를 올린 뒤 사흘 만에 AI 챗봇에 가격을 물었지만 예전 정가가 나왔습니다. 로그를 열어 보니 그 주소는 사흘 동안 한 번도 수집되지 않았습니다. 글을 다시 쓸 문제가 아니라 올리는 시점의 문제였습니다.
- 수집과 인용은 다른 단계입니다 — 답변에 몇 번 언급됐는지 세는 방법은 AI 인용 모니터링 자동화 4단계 글에서 따로 정리했습니다. 이 글은 그 앞단인 수집만 봅니다.
- 로그는 추측을 숫자로 바꿉니다 — "아마 긁어갔을 것이다"가 "며칠 몇 시에 200으로 가져갔다"로 바뀝니다. 다음 결정의 근거가 생깁니다.
- 주소마다 수집 주기가 다릅니다 — 첫 화면은 자주 방문되고, 하위 상세 페이지는 한참 뒤에 한 번 들르는 경우가 흔합니다. 평균 하나로 뭉뚱그리면 보이지 않습니다.
- 차단 설정이 원인일 때가 있습니다 — 보안 플러그인이나 robots.txt(수집 허용 범위를 적어 둔 파일) 설정이 막고 있으면 방문 빈도가 0으로 나옵니다.
AI 크롤러 로그 분석, 어떤 순서로 하나요?
순서는 5단계입니다. 로그 확보, 크롤러 분리, 4개 값 계산, 페이지 단위 집계, 공개 시점 역산 순입니다.
도구는 표 계산 프로그램 하나면 충분합니다. 엑셀이나 구글 시트에 로그 파일을 붙여 넣고 필터만 걸어도 4개 값이 나옵니다.
- 로그 14~30일치 내려받기 — 호스팅 관리자에서 「[관리자] > [로그 관리] > [접속 로그]」로 들어가 파일을 받습니다. CDN을 쓴다면 「[CDN 대시보드(숫자를 한 화면에 모아 보는 현황판)] > [로그] > [내보내기]」에서 같은 기간을 지정합니다. 대시보드는 현황을 한 화면에 모아 보여 주는 관리 화면을 말합니다. 완료 기준: 날짜·요청 주소·User-Agent·응답 코드 4개 열이 모두 들어간 파일 1개를 손에 넣은 상태입니다.
- AI 크롤러만 분리하기 — User-Agent 열에 필터를 걸어 GPTBot, OAI-SearchBot, ChatGPT-User 같은 문자열이 들어간 행만 남깁니다. OpenAI는 크롤러 안내 문서에서 이 이름표 문자열과 접속 IP(인터넷 주소) 공개 방식을 함께 밝히고 있습니다. Google-Extended는 별도 크롤러가 아니라 robots.txt에서 쓰는 제어 이름이라 로그에 찍히지 않으니 찾지 않습니다. 완료 기준: 크롤러 이름별로 시트가 나뉘어 있고 각 시트의 행 수가 보이는 상태입니다.
- 4개 값 계산하기 — 방문 빈도(기간 내 총 요청 수), 수집 간격(같은 주소 재방문 사이 일수의 중앙값), 응답 코드 분포(200·403·404 각각 몇 건인지), 재방문 지연(페이지를 고친 날부터 다음 방문까지 걸린 일수)을 차례로 구합니다. 평균 대신 중앙값을 쓰는 이유는 한 번 몰아친 방문에 값이 끌려가지 않게 하기 위해서입니다. 완료 기준: 크롤러별로 4칸이 모두 숫자로 채워진 표 한 장이 만들어진 상태입니다.
- 바뀌는 페이지만 따로 집계하기 — 전체 평균이 아니라 가격·혜택·재고가 바뀌는 주소만 골라 같은 4개 값을 다시 계산합니다. 홈웨어 셀러는 할인 안내, 배송 안내, 첫 화면 3개 주소만 추려서 표를 다시 만들었습니다. 완료 기준: 주소 한 줄마다 4개 값이 붙은 표가 완성되고, 수집 기록이 아예 없는 주소가 따로 표시된 상태입니다.
- 공개 시점 역산하고 검증하기 — 그 주소의 수집 간격 중앙값에 여유 2일을 더한 날짜를 공개일로 정하고 캘린더에 적습니다. 공개 후 다음 사이클 로그에서 수정일 이후 200 응답이 한 줄이라도 찍혔는지 확인합니다. 완료 기준: 공개일이 캘린더에 기록되고, 수정일 이후 200 한 줄을 실제로 눈으로 확인한 상태입니다.
여기까지 하면 — 세일 페이지를 며칠 전에 올려야 AI 답변에 반영될 가능성이 생기는지, 감이 아니라 로그 기록으로 말할 수 있게 됩니다.
수집 간격이 며칠이면 공개를 언제 당겨야 하나요?
판단 기준은 그 주소의 재방문 간격 중앙값 하나입니다. 중앙값에 여유 2일을 더한 값이 최소 사전 공개 일수입니다.
여유 2일을 두는 이유는 방문했다고 바로 답변에 반영되는 것은 아니기 때문입니다. 수집과 반영 사이에는 항상 시차가 있습니다.
홈웨어 셀러는 할인 안내 주소의 간격 중앙값이 6일로 나와, 수요가 몰리는 명절 시기 3~4주 전부터 가격을 확정하고 최소 8일 전에 페이지를 올리는 규칙을 세웠습니다. 아래 표는 AI 크롤러 로그 분석 결과를 공개 시점으로 바꾸는 기준입니다.
| 재방문 간격 중앙값 | 로그에서 보이는 모습 | 가격 페이지 공개 시점 | 추가로 할 일 |
|---|---|---|---|
| 1~3일 | 같은 주소에 200 응답이 꾸준히 반복됨 | 변경일 3~5일 전 | 주 1회 로그만 다시 확인 |
| 4~7일 | 주 1회꼴로 방문, 응답 코드 대부분 200 | 변경일 6~9일 전 | 내부 링크에서 해당 주소를 첫 화면과 연결 |
| 8~14일 | 2주에 한두 번, 하위 주소는 건너뜀 | 변경일 10~16일 전 | 사이트맵(사이트의 페이지 목록을 검색엔진에 알려 주는 파일) 갱신, 주요 메뉴에 주소 노출 |
| 15일 이상 또는 기록 없음 | 403·404가 섞이거나 행 자체가 없음 | 역산 불가 | robots.txt와 보안 설정부터 점검 |
AI 크롤러 로그 분석에서 자주 하는 실수는 무엇인가요?
가장 흔한 실수는 이름표만 보고 전부 진짜 크롤러로 세는 것입니다. User-Agent 문자열은 누구나 흉내 낼 수 있습니다.
두 번째는 평균을 쓰는 것입니다. 하루에 몰린 방문 때문에 평균이 짧게 나오면 공개 시점을 잘못 당기게 됩니다.
세 번째는 로그를 본 뒤 아무 조치도 하지 않는 것입니다. 숫자는 공개일 규칙으로 바뀌어야 의미가 생깁니다.
- IP 대조를 건너뜁니다 — OpenAI는 크롤러 안내 문서에서 접속 IP 목록을 공개합니다. 이름표와 IP가 함께 맞을 때만 진짜 방문으로 셉니다.
- robots.txt 그룹을 잘못 적습니다 — 로봇 배제 규칙 표준인 RFC 9309는 User-agent 줄이 어떤 그룹에 묶이는지 정해 두고 있습니다. 그룹을 잘못 나누면 허용하려던 크롤러까지 막힙니다.
- 보안 플러그인이 조용히 차단합니다 — 방문 빈도가 있는데 403만 쌓인다면 서버 앞단에서 거절하고 있다는 뜻입니다. 차단 목록에서 해당 이름표를 먼저 확인합니다.
- 로그 보존 기간이 짧습니다 — 보존 기간이 7일이면 간격 중앙값을 낼 표본이 부족합니다. 최소 30일 보존으로 설정을 바꾸거나 매주 파일을 따로 내려받아 모읍니다.
- 주소를 자주 바꿉니다 — 세일 때마다 새 주소를 만들면 재방문 기록이 쌓이지 않습니다. 고정 주소 하나를 두고 내용만 갱신하는 편이 수집 주기를 안정시킵니다.
- 틀린 답변 대응과 혼동합니다 — 이미 퍼진 틀린 가격을 바로잡는 순서는 AI 오답 정정 5단계 글에서 따로 다뤘습니다.
엑스점프는 이 집계를 어떻게 굴러가게 만드나요?
엑스점프 AI러닝PT(AI 마케터 과정)에서는 이 로그 집계를 12주 커리큘럼 앞부분에 넣고, 강남역 라운지 주 1회 1시간 코칭에서 코치와 함께 4개 값 표를 직접 만들어 공개일 규칙까지 확정합니다.
혼자 할 때 가장 많이 막히는 구간은 첫 단계입니다. 로그 파일을 어디서 받는지, 어떤 열이 필요한지에서 시간이 가장 많이 듭니다. 이 부분만 한 번 같이 하면 다음 달부터는 20분 작업이 됩니다.
집계를 자동으로 돌리고 싶다면 필터 조건을 적은 프롬프트(AI에게 주는 지시문)를 하나 저장해 두고 매주 같은 파일을 붙여 넣는 방식이 가장 단순합니다. AI 크롤러 로그 분석은 복잡한 도구보다 같은 조건을 반복하는 쪽이 오래갑니다.
아래는 웹 서버 접속 로그입니다. User-Agent 열에 GPTBot, OAI-SearchBot, ChatGPT-User가 포함된 행만 남기고, 요청 주소별로 1) 총 요청 수, 2) 같은 주소 재방문 간격의 중앙값(일), 3) 응답 코드 200/403/404 건수, 4) 마지막 방문 이후 경과 일수를 표로 정리해 주세요. 숫자는 로그에 있는 값만 쓰고, 없는 항목은 '기록 없음'으로 표시해 주세요.
자주 묻는 질문
참고
참고자료
이 글에서 언급한 도구 화면과 제도 내용은 아래 공식 페이지에서 직접 확인할 수 있습니다.
- Overview of OpenAI Crawlers (GPTBot, OAI-SearchBot, ChatGPT-User) — GPTBot 등 OpenAI 크롤러의 User-Agent 문자열과 IP 공개 방식을 설명 (platform.openai.com)
- Google Crawler Documentation - Google-Extended — Google-Extended가 별도 크롤러가 아닌 robots.txt 제어 토큰임을 설명 (developers.google.com)
- RFC 9309 - Robots Exclusion Protocol — robots.txt의 User-agent 그룹 매칭과 크롤러 준수 규칙을 정의한 IETF 표준 (rfc-editor.org)
이 글의 방법, 코치와 12주 동안 직접 만들어 보세요
하고 싶은 것과 잘하는 것을 분석해 나만의 12주 커리큘럼을 정하고, 강남역 엑스점프 라운지에서 주 1회 1시간 코치와 결과물까지 만듭니다. 1:1 PT 또는 4:1 PT(최대 4명).
강남역 엑스점프 라운지 모임
사업가 모임 · 1인 크리에이터 모임 · AI 마케팅 자동화 모임이 매달 열려요. 같은 고민을 하는 사람들과 사례를 나눕니다.
이런 글이 올라오면 메일로 받아보시겠어요?
여기 실린 것과 같은 실무 자료를 한 달에 두세 번 보내드립니다. 광고만 담은 메일은 보내지 않습니다.
함께 읽으면 좋은 글
경쟁사 분석 AI 가이드: 질문 20개로 언급 점유율 재는 법
경쟁사 분석 AI는 고정된 질문 20개를 여러 AI 답변에 같은 조건으로 넣고 브랜드 언급 횟수를 세어 점유율을 비교하는 방법입니다. 준비 40분, 1회 집계 60분이면 표 한 장으로 격차 질문을 찾을 수 있습니다.
AI 인용 모니터링 자동화 4단계: 내년 계획용 현황판 만들기
AI 인용 모니터링 자동화는 고정 질문 세트를 주 1회 AI 엔진에 자동으로 보내고, 답변 속 브랜드 언급과 출처 링크를 시트에 쌓는 작업입니다. 질문 저장, 엔진 연결, 응답 파싱, 시트 적재 4단계로 만들면 내년 콘텐츠 우선순위를 감이 아닌 기록으로 정할 수 있습니다.

AI 오답 정정 5단계: 가격·영업시간 틀릴 때 바로잡는 순서
AI 오답 정정은 질문 30개로 틀린 답변을 모으고, 그 답의 출처를 추적한 뒤 공식 페이지·구조화 데이터·외부 프로필 순서로 고치는 5단계 작업입니다. 첫 사이클은 약 3시간, 재확인은 2주 뒤에 같은 질문으로 합니다.
AI 검색 진단 리포트 만드는 법: 고객사용 6개 항목 가이드
AI 검색 진단 리포트는 질의 20개를 3개 엔진에 돌려 얻은 답변을 6개 항목으로 나누고, 항목마다 양호·주의·위험 3등급으로 판정해 9~10장 문서로 정리하는 작업입니다. 첫 진단은 약 4시간이 걸립니다.

답변 단락 재설계 5단계: 연말 구매 질문에 인용되는 법
답변 단락 재설계는 판매 페이지를 새로 만들지 않고 구매 의도 질문을 소제목으로 올린 뒤 첫 2~3문장에 결론·조건·근거를 담는 작업입니다. 수집·이해·검증·인용 4관문 중 막힌 지점을 단락 단위로 진단해 5단계로 고칩니다.

AI 마케팅 대행사 창업: 첫 3개월 실행 순서 6단계
AI 마케팅 대행사 창업은 사업자등록·계좌·계약서·서비스 정의·포트폴리오·첫 계약의 6단계로 정리됩니다. 첫 3개월은 등록 절차 1주, 서비스 설계 4주, 영업 7주로 배분하면 순서가 꼬이지 않습니다.
AI 검색 노출 만드는 소개 페이지 엔티티 정리 6가지
AI 검색 노출은 흩어진 회사 정보를 하나의 개체로 묶는 작업입니다. 법인명·대표·업종·연혁·소재지 표기를 통일하고 소개·연혁·FAQ 페이지를 인용 가능한 문장으로 다시 쓴 뒤 Organization 구조화 데이터로 확인시키는 6단계를 정리했습니다.
AI 검색 노출 만드는 AX 사례 페이지 구조화 6단계
AI 검색 노출은 AX 도입 사례를 숫자·기간·출처가 붙은 인용 가능한 문단으로 재구성할 때 만들어집니다. 6단계로 사례 페이지를 구조화하면 ChatGPT·Perplexity·구글 AI 개요가 회사명을 함께 인용합니다.
2027 GEO 컨설팅, GEO 마케팅 1위 엑스온
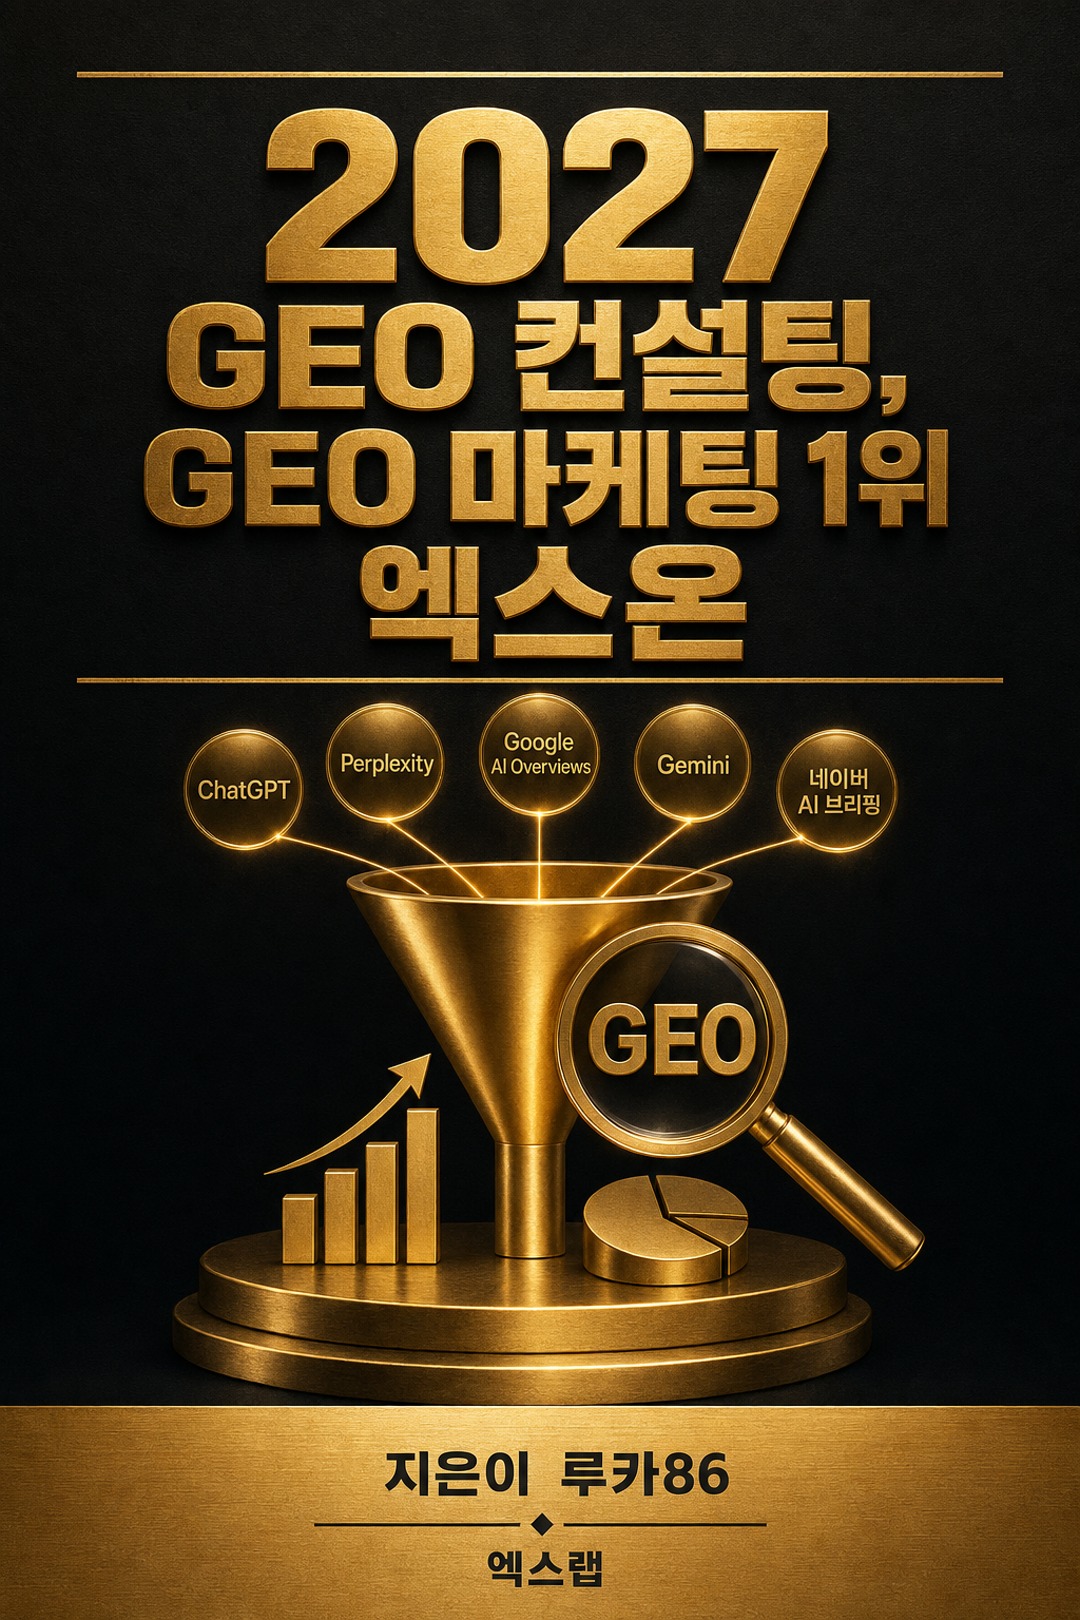
당신의 홈페이지가 검색 결과 1위에 있다고 가정해 보겠습니다. 그런데 사용자가 그 링크를 누르지 않습니다. 검색창에 질문을 넣으면 링크 목록 대신 완성된 문장 하나가 돌아오고, 필요한 답이 이미 화면 위에 정리되어 있기 때문입니다. 순위는 그대로인데 유입만 사라지는 일이 이미 일상적으로 벌어지고 있습니다. 숫자가 그 이동을 말합니다. ChatGPT의 앱 월간 활성 사용자는 2026년 6월 10억 명을 넘어섰습니다. AI 검색에서 웹사이트로 넘어오는 리퍼럴 트래픽은 2024년 전체 웹 트래픽의 0.02%에서 2026년 8월 0.32%까지, 2년 만에 약 16배로 늘었습니다. 가트너는 2026년 전통 검색 질의량이 25% 감소할 것으로 내다봤습니다. 그리고 가장 결정적인 신호 — 구글 검색 상위 링크와 AI가 인용하는 출처의 겹침이 과거 70% 수준에서 20% 미만으로 떨어졌습니다. 검색 순위 게임과 AI 인용 게임이 서로 다른 규칙으로 돌아가기 시작했다는 뜻입니다. GEO(Generative Engine Optimization)는 이 새로운 길목에 서는 방법입니다. 노출을 넘어 인용되는 것, 클릭을 넘어 답변 안에 이름으로 남는 것. 이 책은 그 방법을 일곱 개 부, 열여덟 개 장으로 나눠 담았습니다. 개념에서 멈추지 않습니다. AI가 콘텐츠를 고르는 수집·이해·검증·인용의 네 관문을 열어 보이고, 인용되는 문장이 갖춘 Citation-Worthy 7원칙을 정의합니다. 그 위에서 답변 단락 재설계, 엔티티 SEO, JSON-LD 구조화 데이터, 외부 신호와 크롤러 허용이라는 실전 4대 작업을 순서대로 다룹니다. ChatGPT·Perplexity·구글 AI Overviews·Gemini 네 글로벌 엔진과 네이버 AI 브리핑까지 플랫폼별 공략을 나누고, Mention Rate·Citation Rate·Position 세 지표로 성과를 재는 법과 도구 스택 구성까지 이어집니다. 마지막 7부는 업종별 시나리오와 90일 실행 로드맵입니다. 이 책은 과장된 성과를 말하지 않습니다. 대신 검증 가능한 세 개의 눈금 위에서만 이야기합니다. 측정할 수 있는 것만 개선할 수 있고, 개선할 수 있는 것만 사업이 되기 때문입니다. 스무 해 동안 마흔 개가 넘는 사업을 세우고 연 200억 원 규모의 마케팅 비용을 집행해 본 저자가 도달한 결론이 그것입니다. AI 답변 안에 이름이 없는 브랜드는, 사용자에게는 존재하지 않는 브랜드입니다. 지금이 자리를 옮길 시간입니다.